VLA 모델이란? 보는 AI에서 행동하는 로봇으로
“컵을 집어줘.”
사람에게는 간단한 부탁이지만, 로봇이 이 작업을 수행하려면 여러 과정을 거쳐야 합니다. 컵이 어디에 있는지 파악하고, 어떤 방향으로 팔을 움직일지 정한 뒤, 적절한 위치에서 그리퍼(물체를 잡는 장치)를 닫아야 합니다. 컵을 알아보고 지시를 이해하는 것에 더해, 로봇이 실제로 실행할 행동을 만들어내야 하는 것입니다.
이처럼 시각 정보와 언어 지시를 실제 행동으로 연결하도록 학습한 모델을 VLA(Vision-Language-Action) 모델이라고 합니다.
그렇다면 “컵을 집어줘”라는 말은 어떻게 로봇의 움직임으로 바뀔까요? 모델은 행동을 어떤 방식으로 표현하고, 주변 상황이 달라지는 동안 어떻게 다음 움직임을 이어갈까요?
이번 글에서는 장면을 이해하는 모델과의 차이부터 시작해, 컵을 집는 예시를 따라 VLA의 작동 흐름과 행동 표현 방식을 살펴봅니다.
이어 실제 로봇에서 중요한 실시간성과 시각 이해의 역할, 그리고 행동과 미래 장면을 함께 예측하는 최근 흐름까지 알아봅니다.
VLM과 VLA는 무엇이 다를까?
탁자 왼쪽에 컵이 놓여 있습니다. 이 장면을 찍은 사진과 함께 “컵이 어디 있어?”라고 물으면, VLM(Vision-Language Model)은 “탁자 왼쪽에 있습니다”라고 답할 수 있습니다. VLM은 사진 속 물체를 알아보고, 물체 사이의 위치 관계를 설명하고, 장면에 관한 질문에 답하는 데 활용할 수 있습니다.
같은 장면에서 “컵을 집어줘”라는 지시를 받은 VLA는 팔을 어느 방향으로 얼마나 움직일지, 그리퍼를 언제 닫을지 같은 행동값을 출력합니다. 로봇 제어기는 이 값을 받아 팔과 그리퍼를 실제로 움직입니다.
VLA를 만드는 대표적인 방법 중 하나는 장면과 언어를 이해하도록 학습한 VLM에 로봇의 행동 데이터를 추가로 학습시키는 것입니다. 2023년 공개된 구글 딥마인드의 RT-2는 기존 시각·언어 모델을 바탕으로 로봇의 움직임을 기록한 데이터와 시각·언어 데이터를 함께 학습했습니다. 이 과정에서 로봇의 행동을 텍스트 토큰(모델이 글을 처리하는 기호 단위)으로 표현했습니다.
VLA는 다른 로봇 AI 개념과 함께 쓰이기도 합니다. 여러 작업과 로봇에 쓰는 공통 기반인 로봇 파운데이션 모델(RFM)을 VLA 방식으로 구현하면, 하나의 모델이 두 가지에 모두 해당합니다. 또 여러 작업의 순서를 계획하는 에이전트와, 각 작업의 움직임을 생성하는 VLA를 연결하는 구조도 연구되고 있습니다.
다시 컵 이야기로 돌아가 보겠습니다. VLA는 무엇을 입력받고, 어떤 순서로 행동값을 만들어낼까요?
“컵을 집어줘”는 어떻게 움직임이 될까?
컵이 같은 자리에 있어도 로봇 팔이 어디에 놓여 있는지에 따라 필요한 움직임은 달라집니다. 팔이 이미 컵 가까이에 있다면 조금만 움직이면 되고, 멀리 있다면 더 뻗어야 합니다.
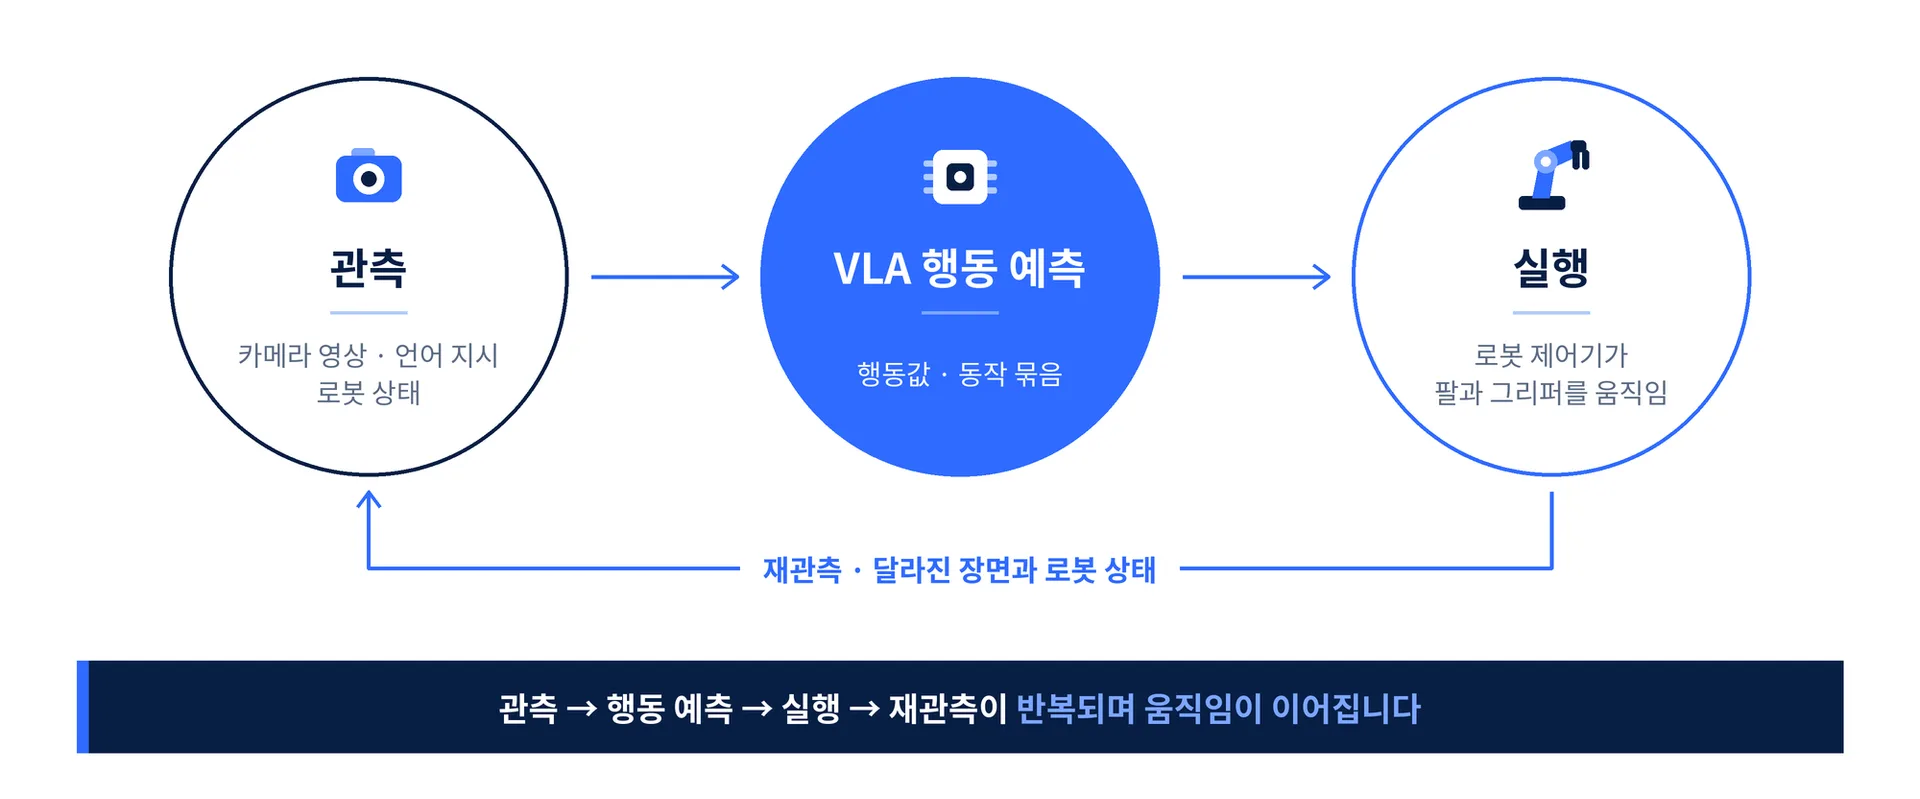
VLA는 먼저 카메라 영상과 “컵을 집어줘”라는 언어 지시를 입력받습니다. 모델에 따라 관절이 현재 어느 위치에 있는지, 그리퍼가 열려 있는지처럼 로봇 자신의 상태도 함께 입력받습니다.
이 정보를 바탕으로 모델은 로봇이 실행할 행동값을 예측합니다. 어떤 모델은 손끝을 얼마나 이동시키고 회전시킬지 출력합니다. 관절이 도달해야 할 각도나 움직이는 속도를 출력하는 모델도 있습니다. 행동값의 형태는 모델이 학습한 데이터와 로봇의 제어 방식에 따라 달라집니다.
로봇이 행동을 실행해 팔의 위치가 달라지면, 모델은 달라진 상황을 다시 관측해 다음 행동을 예측합니다. 이렇게 관측 → 행동 예측 → 실행 → 재관측의 과정이 반복되면서 움직임이 이어집니다. 일부 모델은 앞으로 이어질 여러 행동값을 한꺼번에 예측하기도 합니다. 예측한 여러 행동값을 동작 묶음이라고 합니다.
그럼 손끝의 이동량이든 관절 각도든, 모델은 이러한 행동값을 어떤 방식으로 만들어낼까요?
로봇은 행동을 어떻게 표현할까?
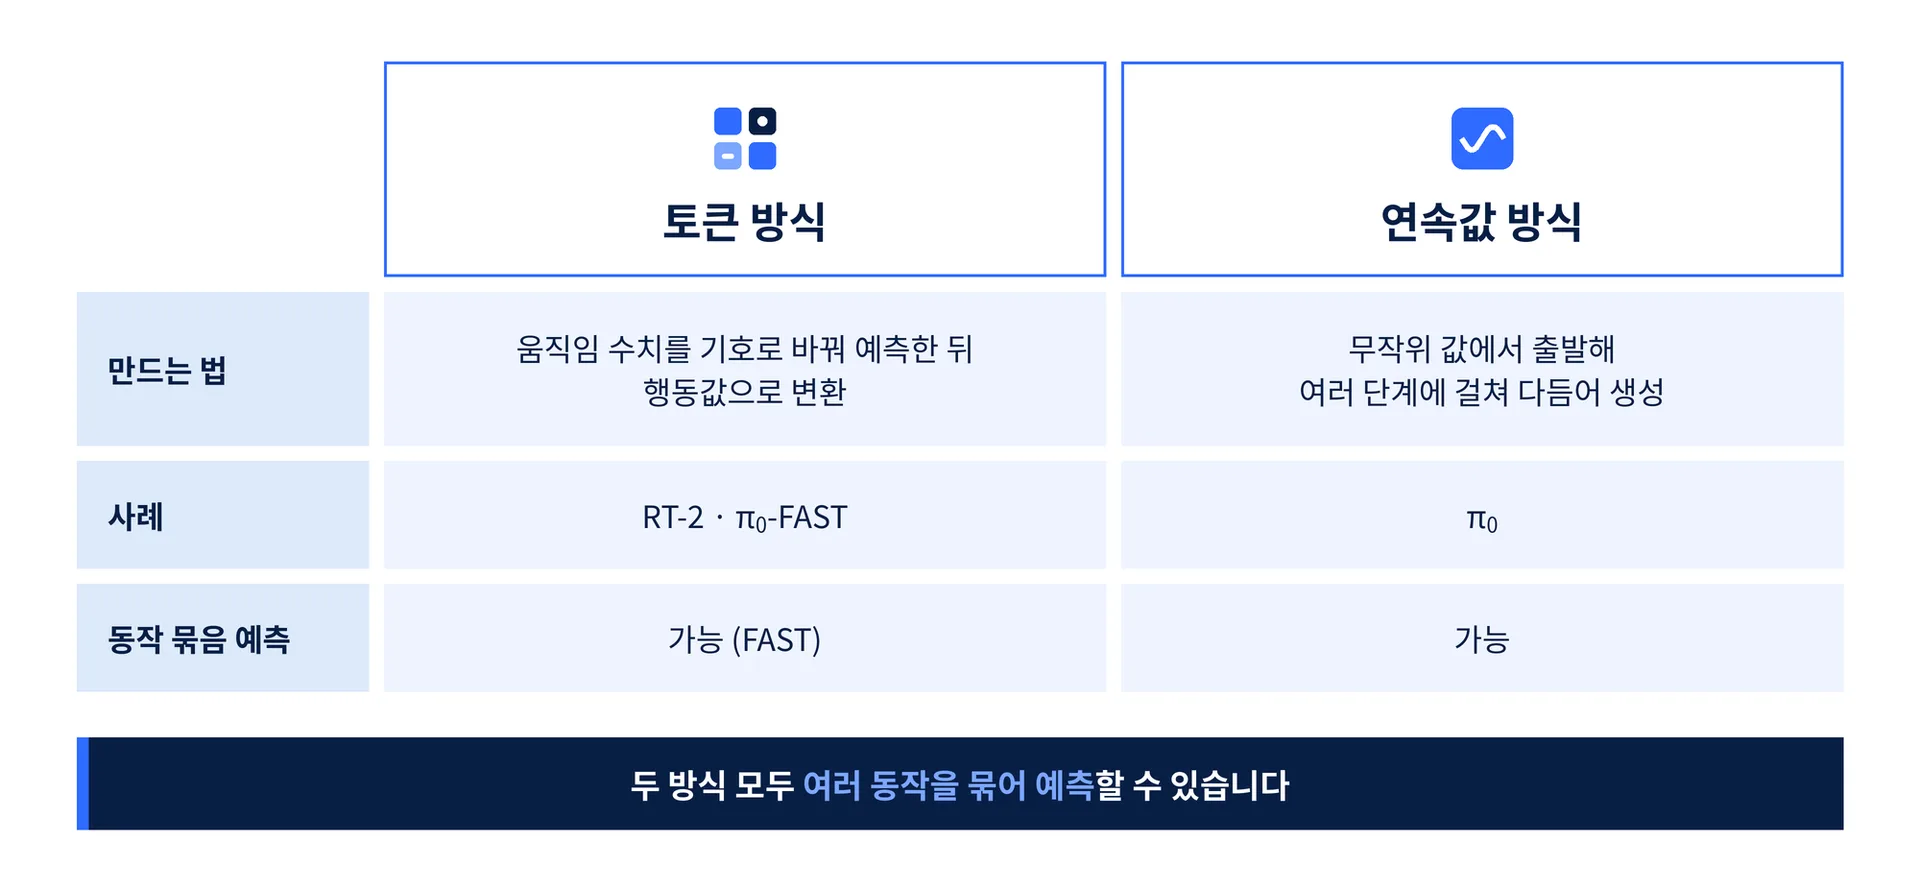
행동값을 만드는 대표적인 방법으로는 토큰을 예측하는 방식과 연속값을 생성하는 방식이 있습니다.
먼저 1장에서 본 RT-2처럼 행동을 텍스트 토큰으로 표현하는 방식이 있습니다. 예를 들어 손끝의 이동량을 1cm 간격으로 나누고, 0.5cm가 속한 구간은 A, 1.5cm가 속한 구간은 B로 표시할 수 있습니다. 움직임을 이런 기호로 바꾸면 모델은 문장을 만들듯 토큰을 예측합니다. 생성된 토큰은 다시 로봇이 실행할 행동값으로 변환됩니다.
미국 로봇 AI 기업 Physical Intelligence는 수치를 구간별로 나눠 기호로 바꾸는 단순한 방식이 자사의 정교한 로봇 조작 실험에서 한계를 보였다고 설명했습니다. 이를 보완하기 위해 2025년 1월 소개한 FAST는 앞으로 이어질 움직임의 패턴을 압축해 동작 묶음을 토큰으로 표현합니다. π₀-FAST는 이 토큰화 방식을 활용하는 VLA 모델입니다.
연속값 방식에서는 이동량·회전량·관절 각도에 해당하는 수치를 모델이 직접 생성합니다. 같은 회사의 π₀는 여기에 플로 매칭이라는 방법을 사용합니다. 무작위 값에서 출발해, 로봇이 관측한 상황과 받은 지시에 맞는 행동값이 되도록 여러 단계에 걸쳐 다듬습니다.
모델이 동작 묶음을 계산하는 데에도 시간이 걸립니다. 그동안 로봇은 어떻게 움직임을 이어갈 수 있을까요?
로봇은 다음 행동을 얼마나 빨리 결정해야 할까?
로봇 제어기가 다음 행동을 실행해야 하는 시점에 그 행동값이 준비돼 있어야 합니다. 컵을 향해 팔을 뻗는 동안 제어기는 짧은 간격마다 행동값을 실행합니다. 모델이 다음 동작을 계산하는 사이 팔이 움직였다면, 새 동작은 달라진 팔의 위치에서 자연스럽게 이어져야 합니다.
Physical Intelligence가 소개한 모델 설정에서는 1초 분량에 해당하는 50개 시점의 행동값을 한 묶음으로 예측합니다. 로봇이 멈추지 않으려면, 이 묶음을 실행하는 동안 다음 묶음이 준비돼야 합니다.
모델이 입력을 받아 결과를 계산하는 과정을 추론이라고 합니다. 계획한 동작 구간을 실행한 뒤 다음 묶음을 계산하는 동기식 추론에서는 계산이 끝날 때까지 팔이 잠시 멈출 수 있습니다. 계산을 미리 시작해도 새 묶음이 현재 움직임과 맞지 않으면, 전환하는 순간 팔이 갑자기 빨라지거나 동작이 끊길 수 있습니다.
Physical Intelligence가 제안한 실시간 청킹(Real-Time Chunking, RTC)은 행동값을 여러 단계에 걸쳐 다듬어 만드는 VLA에 적용할 수 있습니다. 3장에서 살펴본 π₀의 플로 매칭, 그리고 비슷한 원리의 확산 방식이 여기에 해당합니다. 로봇은 모델이 다음 묶음을 계산하는 동안 앞서 정해 둔 동작을 실행합니다. 모델은 두 묶음이 겹치는 구간의 움직임을 고려해 새 동작이 자연스럽게 이어지도록 행동값을 만듭니다.
연구진은 기존 추론 지연에 최대 200ms(0.2초)를 인위적으로 더해 가며 성능을 비교했습니다. 평균 작업 처리량은 각 시도에서 작업을 얼마나 완료했는지 그 비율을 소요 시간으로 나눈 뒤 평균한 값입니다. 실험한 작업에서 동기식 추론의 평균 작업 처리량은 지연이 늘어날수록 떨어졌습니다. 같은 실험에서 실시간 청킹을 적용한 방식은 지연을 추가하기 전과 비슷한 수준을 유지했습니다.
빠른 추론은 다음 행동을 제때 준비하는 데 중요합니다. 그 행동을 끊김 없이 실행하려면, 모델이 계산하는 동안에도 로봇이 현재 움직임을 이어가고 필요한 순간에 다음 동작으로 넘어갈 수 있도록 설계해야 합니다.
움직임을 정하기에 앞서 로봇은 작업 대상에서 어떤 정보를 읽어야 할까요?
잘 움직이려면 먼저 잘 봐야 한다
답은 작업 대상의 위치와 형태, 그리고 현재 상태입니다. 대상이 움직인다면 영상 속 변화도 읽어야 합니다. 컵 대신 산업 현장에서 용접할 부재를 다룬다면, 어느 부분에 작업해야 하는지 먼저 찾아야 합니다.
배키 비전 3B는 이런 역할을 하는 ‘VLA의 눈’에 비유할 수 있습니다. 로봇과 산업용 엣지 기기(현장에서 AI를 직접 실행하는 장비)의 제한된 하드웨어 자원을 고려해 설계한 경량 시각·언어 모델(VLM)입니다. 영상 입력에서는 프레임 사이의 관계를 분석해 미세한 동작과 물체의 궤적을 파악하도록 만들어졌습니다.
현장에 맞춘 추가 학습의 효과는 용접 특화 모델의 평가에서 확인할 수 있습니다. 기존 베이스 모델 대비, 용접 특화 모델의 ‘위치 및 형상 인식(RefWeld) 박스 정확도’는 5.3점에서 72.5점으로 높아졌습니다. 이 점수는 이미지 속 작업 대상의 위치와 형태를 찾아내는 인식 성능만을 보여줍니다.
NC AI는 배키 비전 3B를 고도화해 로봇 및 엣지 장비에 핵심 시각 엔진이자 VLA 기반 모델로 본격 탑재할 계획입니다.
나아가 로봇이 다음 행동과 그 행동으로 달라질 장면을 함께 예측할 수 있다면 어떨까요?
행동과 그다음 장면을 함께 예측하는 AI
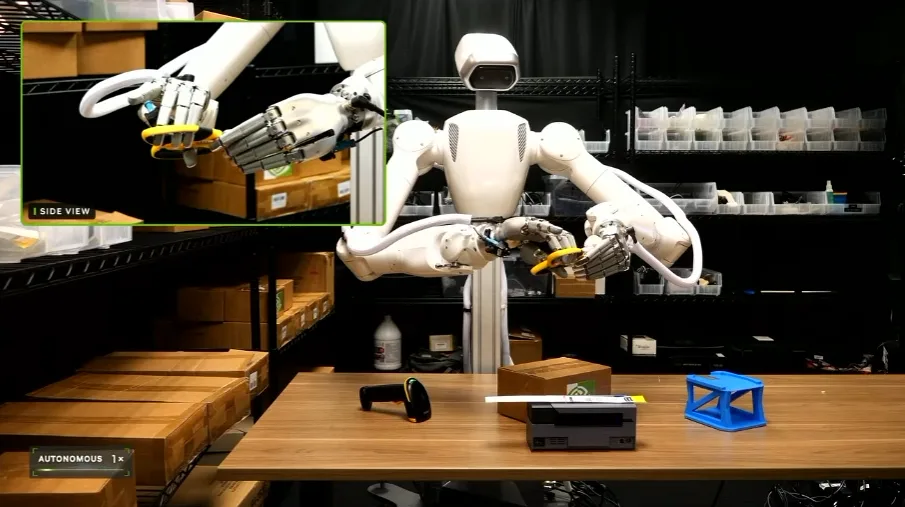
NVIDIA가 GTC 2026에서 예고하고 같은 해 11월 연구 내용을 공개한 GR00T 계열의 새 모델 GR00T 2가 그 사례입니다. NVIDIA는 이 모델을 월드 액션 모델(World Action Model, WAM)이라고 부릅니다. 최근 카메라 영상과 작업 지시, 로봇의 현재 상태를 입력받아 미래 영상과 동작 묶음을 함께 예측합니다. 로봇은 예측한 행동을 실행한 뒤 새로 관측한 정보를 바탕으로 같은 과정을 반복합니다.
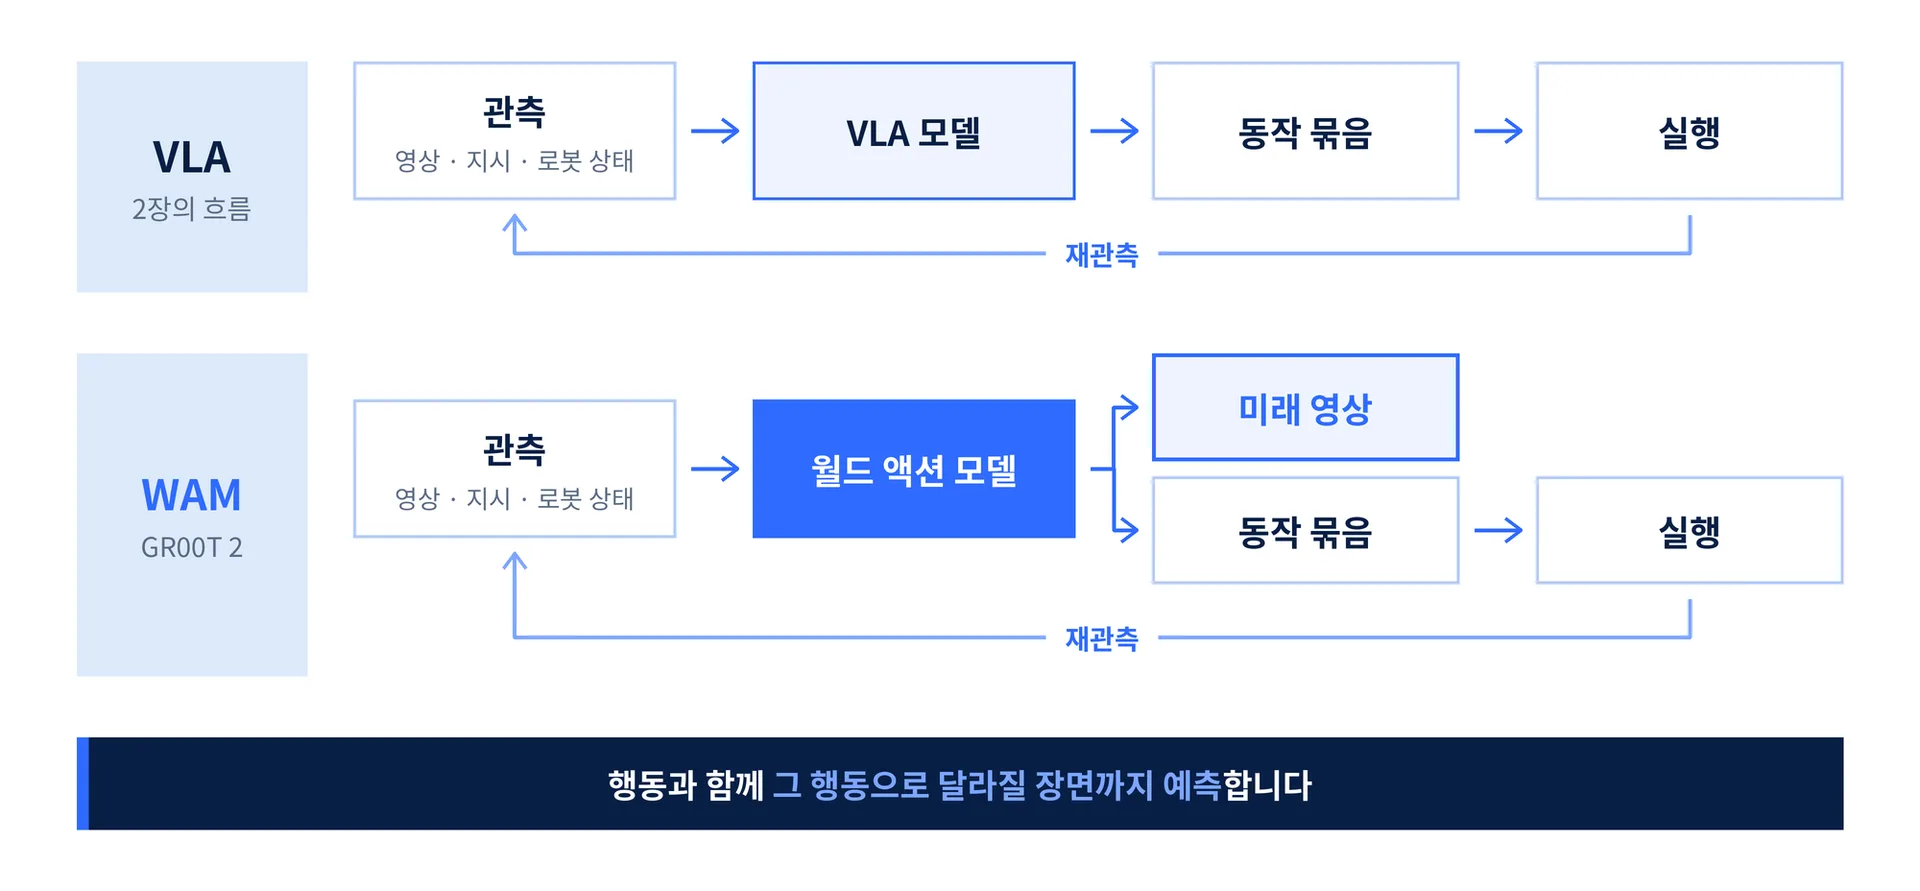
2장에서 살펴본 흐름에 행동 이후의 장면을 예측하는 과정이 더해진 셈입니다.
로봇이 잘 움직이려면 주변을 보고 지시를 이해한 뒤, 실행할 행동을 만들어 필요한 순간에 이어가야 합니다. 각 기술은 서로 다른 역할을 맡고, 로봇이 움직이는 과정에서 그 역할들이 점차 연결되고 있습니다.
언어를 다루는 LLM, 장면을 이해하는 VLM, 행동을 만드는 VLA, 행동의 결과를 예측하는 월드모델.
NC AI는 이 흐름을 따라 현실에서 보고, 판단하고, 움직이는 AI를 만들어가고 있습니다.
함께 보면 좋은 글
NC AI가 그리는 ‘피지컬 AI’의 미래
[참고자료]
Google DeepMind, 「RT-2: New model translates vision and language into action」 (2023.07)
Physical Intelligence, 「FAST: Efficient Robot Action Tokenization」 (2025.01)
Physical Intelligence, 「π₀: A Vision-Language-Action Flow Model for General Robot Control」 (2024.10)
Physical Intelligence, 「Real-Time Action Chunking with Large Models」 (2025.06)
Black et al., 「Real-Time Execution of Action Chunking Flow Policies」 (2025.06)
NC AI, 「NC AI, ‘배키 비전 3B’ 개발… 글로벌 동급 SOTA 달성」 (2026.11)
NVIDIA, 「GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and Adaptation」 (2026.11)
Conference on Robot Learning, 「CoRL 2026 Day 1」 (2026.11, NVIDIA Jim Fan 기조연설, 시연 장면 5:41:53)


