Speech-to-Speech 모델은 어떻게 대화하고 도구를 사용할까?
작성자
권대욱 · NC AI
음성 대화 모델과 에이전트를 활용한 서비스를 개발하고 있습니다.
이 글에 담긴 기술적 해석과 설계 제안은 필자의 견해입니다.
이런 분이 읽으면 좋습니다!
LLM이나 챗봇을 개발해봤지만 음성 모델은 아직 낯선 분, 음성 에이전트에 캘린더·메일·검색 같은 도구를 붙이려는 분.
이 글로 알 수 있는 내용
S2S 모델의 기본 개념과 주요 구조, 대화 타이밍을 다루는 방법, 외부 도구를 연결하고 실행 결과를 관리하는 서비스 설계.
이 글의 구성
음성 모델이 처음이라면 2~4장부터, 도구 연동 구조가 궁금하다면 5~8장을 중심으로 읽어도 좋습니다.
1. 들어가며: “오늘 우산 챙겨야 할까?”에서 “내일 회의 잡아줘”까지
출근 준비 중 음성 비서에게 이렇게 묻는 상황을 생각해봅시다.
사용자: “오늘 우산 챙겨야 할까? 퇴근할 때 비 오나?”
AI: “어디에서, 몇 시쯤 퇴근하시나요?”
사용자: “판교에서 저녁 일곱 시쯤.”
서비스는 먼저 질문에서 지역과 시간대를 파악해야 합니다. 빠진 정보는 사용자에게 묻고, 그 조건에 맞는 예보를 조회해 답합니다. 조회에 실패했다면 예보를 확인하지 못했다고 알려야 합니다.
이어서 사용자가 다른 일을 부탁한다고 해봅시다.
사용자: “내일 오후에 태하 씨랑 30분 회의 잡아줘. 시작하기 10분 전에 알려주고.”
이번에는 외부 정보를 읽는 것으로 끝나지 않습니다. 태하 씨가 누구인지 찾고, 일정을 확인하고, 참석자를 초대해야 합니다. 대화 도중 “잠깐, 초대는 보내지 마”라는 말이 나오면 이미 진행 중인 작업도 살펴봐야 합니다.
날씨 조회와 회의 예약을 나란히 놓으면 음성 모델이 하는 일과 서비스가 맡아야 할 일이 더 잘 보입니다. 먼저 음성을 입력받아 음성으로 응답하는 Speech-to-Speech(S2S) 모델을 살펴보고, 캘린더를 연결하는 예제로 이어가겠습니다. 전반부는 개념과 모델 구조를, 후반부는 예제 서비스의 설계와 코드를 다룹니다.
이 글에서는 사용자와 대화하는 과정과 외부 시스템에 작업을 요청하는 과정을 나누어 살펴봅니다. 음성 재생을 멈추는 것과 이미 보낸 초대를 취소하는 것은 다른 일입니다. “처리했어요”라는 답변만으로 일정이 실제로 저장됐는지도 알 수 없습니다. 요청을 이해하고 답하는 모델과, 실행을 검증하는 서비스 코드가 어떻게 연결되는지 살펴보겠습니다.
2. 네 가지 용어부터 정리하기
2.1 음성으로 답한다고 내부 구조가 같은 것은 아니다
음성 인식(Automatic Speech Recognition, ASR)은 말소리를 텍스트로 바꾸고, 음성 합성(Text-to-Speech, TTS)은 텍스트에 해당하는 음성을 만듭니다. 두 기능 사이에 대규모 언어 모델(LLM)을 놓으면 ASR → LLM → TTS 형태의 음성 대화 시스템이 됩니다. 각 단계의 출력을 다음 단계에 전달하는 구성을 캐스케이드라고 부릅니다. [1][8]
반면, End-to-End로 동작하는 통합 음성 모델은 입력 음성에서 얻은 표현을 언어 모델에 전달하거나 음성 토큰을 직접 모델링하는 등, 음성 이해와 응답 생성을 하나의 모델 구조 안에서 다룹니다. 같은 통합 모델끼리도 차이가 있습니다. 예를 들어 Kyutai의 음성 대화 모델 Moshi(영어 지원)와 Qwen Team의 멀티모달 모델 Qwen3-Omni(한국어 포함 다국어 음성 입출력)는 내부 표현과 음성 생성 방식이 다릅니다. 두 모델의 구체적인 차이는 4장에서 살펴보겠습니다. 이 글의 한국어 대화는 서비스 흐름을 설명하기 위한 예시이며, 소개하는 모델 중에는 한국어를 지원하지 않는 모델도 있습니다. [1][3]
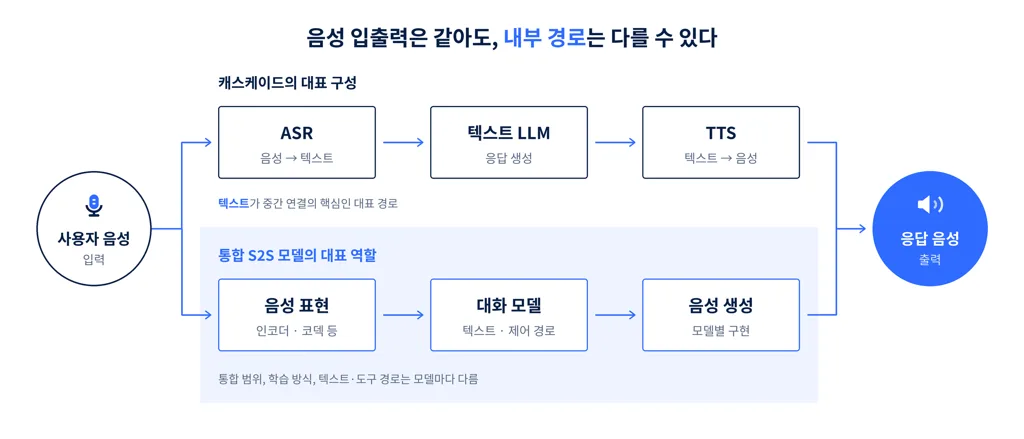
여기서 S2S는 음성을 받아 음성으로 답하는 대화 작업을 뜻합니다. 넓게는 음성 번역도 포함할 수 있지만, 이 글에서는 대화형 에이전트로 범위를 좁힙니다. 시스템의 입출력을 설명할 때와 통합 모델의 구조를 설명할 때를 구분해서 읽으면 혼동이 줄어듭니다.
2.2 S2S, E2E, Streaming, Duplex는 서로 다른 질문이다
모델 소개에서 자주 나오는 네 표현을 아래처럼 나눠보겠습니다.
용어 | 먼저 확인할 질문 |
|---|---|
Speech-to-Speech | 음성을 입력받아 음성으로 응답하는가? |
End-to-End | 저자는 어디까지를 하나의 모델이나 처리·학습 과정으로 묶었는가? |
Streaming | 입력이나 출력이 전부 완성되기 전에 일부를 순차 처리하는가? |
Half / Full-Duplex | 듣기와 말하기가 번갈아 진행되는가, 동시에 진행될 수 있는가? |
E2E라고 해서 내부에 텍스트가 없는 것은 아닙니다. Moshi는 발화 텍스트도 함께 모델링합니다. 따라서 이름만 보고 내부 표현이나 공동 학습 여부를 결정하기보다, 저자가 설명하는 연결과 학습 범위를 확인하는 편이 정확합니다. [1]
Duplex는 특히 대화가 오가는 방식과 관련이 있습니다. AI가 답하는 동안에도 새 말을 받아들일 수 있는지에 따라, 사용자가 정정하거나 끼어들 수 있는 시점이 달라집니다.
3. AI는 언제 듣고, 언제 말할까?
3.1 Half-Duplex와 Full-Duplex
Half-Duplex, 즉 반이중은 양쪽이 번갈아 주고받는 방식입니다. 한쪽이 말하는 동안 다른 쪽은 듣기만 합니다. 무전기를 떠올리면 쉽습니다. 음성 인터페이스에 적용하면 사용자가 말하고, AI가 답한 뒤, 다시 사용자의 입력을 받는 흐름입니다. 여기서는 네트워크 장비의 전송 규격보다 대화 처리의 동시성을 설명하는 용어로 사용합니다. [8]
Full-Duplex, 즉 전이중에서는 시스템이 응답 음성을 생성하면서 사용자 음성 입력도 처리할 수 있습니다. Moshi는 사용자 음성과 에이전트 음성을 별도 스트림으로 다뤄 이 동시 처리를 구현합니다. [1]
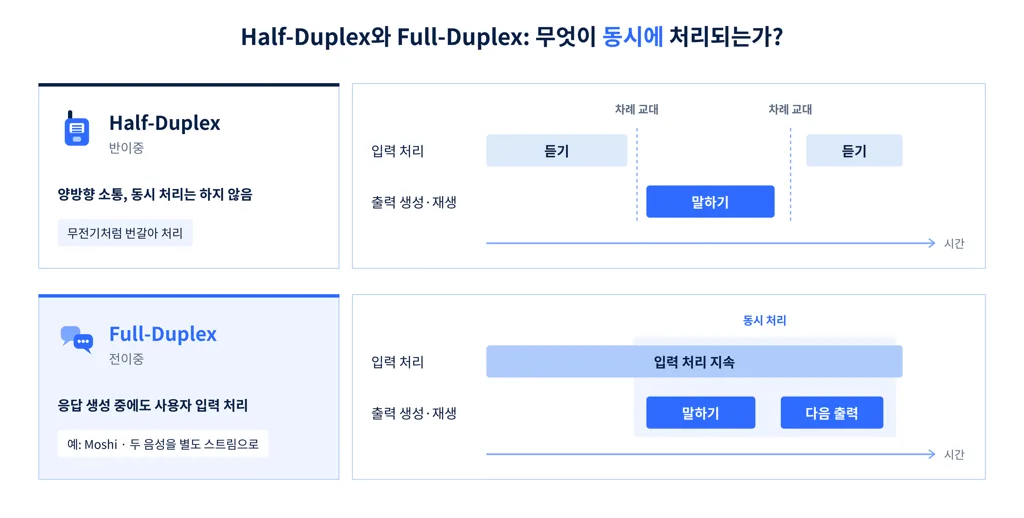
전이중이라고 항상 말을 겹쳐야 하는 것은 아닙니다. 사용자가 말할 때 듣기만 하거나, 짧게 맞장구를 치거나, 자신의 설명을 멈추는 행동도 필요합니다. 마이크가 켜져 있는 것과 모델이 새 입력을 응답에 반영하는 것도 구분해야 합니다. 동시에 처리할 수 있는 구조와, 적절한 순간에 반응하는 능력은 따로 봐야 합니다.
턴 기반이면 모두 반이중일까?
꼭 그렇지는 않습니다. 응답을 턴 단위로 관리하면서도 사용자 발화를 감지해 출력을 중단할 수 있습니다. 음성 에이전트 개발 프레임워크인 LiveKit Agents도 턴 종료 판단과 끼어들기 처리를 별도 기능으로 다룹니다. 캐스케이드 구성으로 Full-Duplex를 구현하는 DuplexCascade 연구도 있습니다. 캐스케이드와 E2E를 반이중과 전이중에 일대일로 대응시키면 안 됩니다. [8][9]
3.2 스트리밍은 ‘조금씩 처리하는 것’이다
사용자의 질문이 끝난 뒤 답변 오디오를 조금씩 전송한다고 해봅시다. 이는 오디오 전송의 스트리밍입니다. 모델도 답변을 생성하는 즉시 조각을 내보내는지, 완성된 음성을 전송할 때만 나누는지는 별도로 확인해야 합니다. 어느 경우든 전송 방식만으로는 응답 중 새 사용자 입력을 처리하는지 알 수 없습니다.
Qwen3-Omni의 기술 리포트와 공식 저장소는 텍스트와 음성을 스트리밍으로 생성하는 구조를 설명합니다. 이를 검토할 때도 입력을 순서대로 처리하는지, 출력을 조금씩 만드는지, 듣기와 말하기를 동시에 하는지를 각각 봐야 합니다. 조금씩 생성하는 것과 말하면서 듣는 것은 다른 특성입니다. [3][4]
3.3 잠깐 쉬는 것과 말을 끝내는 것은 다르다
“퇴근할 때…”라고 말하다가 잠깐 생각할 수 있습니다. 그 침묵을 질문의 끝으로 처리하면 AI가 성급하게 답하기 시작합니다. 반대로 지나치게 오래 기다리면 대화가 답답해집니다.
음성 활동 감지(Voice Activity Detection, VAD)는 말소리가 있는 구간을 찾습니다. 사용자가 잠깐 쉬는 것인지, 말을 마친 것인지 판단하는 턴 종료 감지는 다른 문제입니다. LiveKit의 공식 문서는 음성 활동 정보와 함께 발화의 의미를 활용하는 종료 판단도 설명합니다. [9]
개념 | 대화에서 풀어야 할 문제 |
|---|---|
VAD | 지금 사람의 말소리가 있는가? |
턴 종료 판단 | 잠깐 생각하는 중인가, 질문을 마쳤는가? |
끼어들기(Barge-in) | 설명을 멈추고 “판교 말고 부산”이라는 새 요청을 받아야 하는가? |
맞장구(Backchannel) | “응, 그렇구나”는 듣고 있다는 반응인가, 새 발언의 시작인가? |
“응”이라는 단어만으로 맞장구인지 새 발언인지 정하기는 어렵습니다. 말한 시점과 앞뒤 문맥도 봐야 합니다. LiveKit의 문서도 적응형 끼어들기 처리에서 맞장구와 실제로 말을 끊으려는 발화를 구분하는 방법을 설명합니다. [9]
여기까지는 언제 반응할지에 대한 이야기였습니다. 이제 소리 자체가 모델 안에 어떤 형태로 들어가는지 살펴보겠습니다.
4. 소리는 모델 안에서 어떻게 처리될까?
4.1 파형, 인코더, 코덱, 토큰
디지털로 녹음된 음성은 파형을 일정한 시간 간격으로 측정한 샘플 값을 나열한 것입니다. 음성 인코더는 파형이나 파형에서 계산한 음향 특징을 받아 모델이 사용할 벡터를 만듭니다. 신경망 오디오 코덱은 음성을 압축된 표현으로 바꾸는 인코더와, 그 표현에서 파형을 복원하는 디코더로 이루어집니다. 두 용어는 관련이 있지만 같은 부품을 뜻하지는 않습니다. [2][7]
Moshi에서 사용하는 오디오 코덱 Mimi는 짧은 음성 구간을 여러 개의 코드북 토큰으로 표현합니다. 코드북은 학습된 벡터를 모아둔 표이고, 토큰은 그중 어떤 항목을 사용할지 나타내는 번호입니다. 프레임은 음성을 일정한 시간 간격으로 처리할 때의 단위입니다. Mimi의 한 프레임에는 여러 코드북에서 선택한 토큰이 들어갑니다. 이런 오디오 토큰은 소리의 표현을 구성하며, 하나가 한 글자나 음절에 대응하는 것은 아닙니다. [2]
처음에는 아래 세 역할만 구분해도 다음 구조를 따라갈 수 있습니다.
인코더는 소리를 모델용 표현으로 바꾸고, 대화 모델은 맥락을 처리하며, 음성 생성부는 응답을 실제 소리로 만듭니다. 이 역할을 어디에서 나누고 어떤 표현으로 연결하는지가 모델별 차이입니다.
4.2 Moshi: 사용자와 에이전트의 음성을 같은 시간축에 놓기
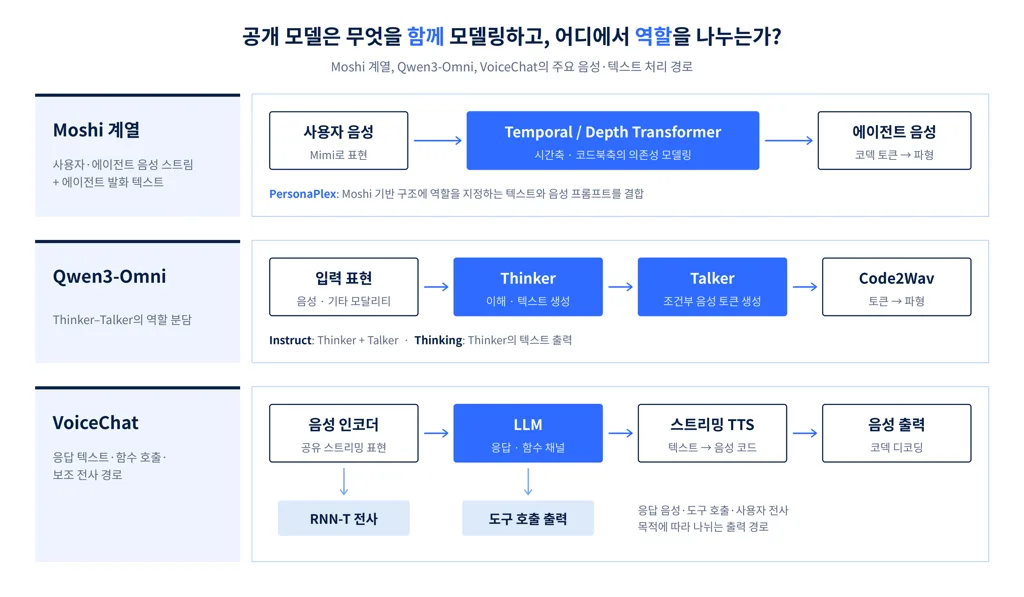
Moshi는 사용자 음성과 에이전트 음성을 별도 스트림으로 다룹니다. 에이전트가 말할 내용에 대응하는 텍스트도 함께 예측합니다. 논문의 ‘Inner Monologue’는 음성과 시간을 맞춘 이 텍스트 흐름을 가리킵니다. [1]
구조는 두 관계를 나누어 생각하면 이해하기 쉽습니다. 하나는 앞뒤 시점의 소리가 어떻게 이어지는지이고, 다른 하나는 같은 시점의 음성 프레임을 표현하는 여러 코드북 토큰이 어떻게 연결되는지입니다. 공식 구현은 각각 Temporal Transformer와 Depth Transformer로 이 관계를 다룹니다. [2]
프레임 수와 토큰 수
Mimi의 12.5Hz라는 프레임 속도는 80ms마다 프레임 하나를 만든다는 뜻입니다. 프레임 안에는 여러 코드북 토큰이 있으므로 ‘1초에 토큰이 총 12.5개’라고 읽으면 안 됩니다. [2]
4.3 Qwen3-Omni: 이해하는 부분과 말하는 부분을 나누기
Qwen3-Omni는 Thinker–Talker 구조를 사용합니다. Thinker는 입력을 해석하고 텍스트 응답을 만듭니다. Talker는 대화 이력, 멀티모달 표현, 현재 생성 중인 텍스트를 받아 음성 토큰을 생성합니다. 음성 복원 모듈인 Code2Wav는 이 토큰을 파형으로 바꿉니다. 이때 사용하는 인과적 합성곱은 파형을 복원하는 단계에서 미래의 오디오 토큰에 의존하지 않도록 구성한 연산입니다. 따라서 파형 복원에 필요한 토큰이 준비된 구간부터 출력을 만들 수 있습니다. [3, §2.4]
핵심은 Talker가 답변 문장이 완성되기를 기다리지 않고, 생성 중인 텍스트와 대화 맥락을 바로 이용한다는 점입니다. 실행할 모델 종류도 구분해야 합니다. 공식 저장소의 Instruct에는 Thinker와 Talker가 포함되지만, Thinking과 Captioner는 Thinker만으로 텍스트를 출력합니다. 같은 Qwen3-Omni 계열이라도 음성 출력 지원 범위가 다릅니다. [3][4]
4.4 NVIDIA PersonaPlex와 NVIDIA NemotronLabs VoiceChat-11B: 역할 제어와 도구 호출로 확장하기
NVIDIA의 Full-Duplex 음성 대화 모델 PersonaPlex는 Moshi를 기반으로 하며, 공개 모델 기준으로 영어 음성 입력과 영어 음성 출력을 지원합니다. 대화 역할을 지정하는 텍스트 프롬프트와 목소리의 특성을 지정하는 음성 프롬프트를 함께 사용합니다. 상담원이나 캐릭터처럼 에이전트의 역할과 목소리를 바꿔야 하는 서비스라면 참고할 만한 구조입니다. [5]
NVIDIA NemotronLabs VoiceChat-11B(이하 VoiceChat)는 영어를 대상으로 하는 도구 호출 지원 음성 대화 모델로, 음성 인코더, LLM, 스트리밍 TTS를 연결합니다. LLM은 사용자에게 말할 응답 텍스트와 외부 도구에 전달할 함수 호출을 별도 출력 경로로 생성합니다. 사용자 발화를 텍스트로 옮기는 RNN-T 기반의 보조 음성 인식 모듈도 둡니다. 응답 음성, 사용자 전사, 도구 호출이 용도별로 나뉘어 있다는 점이 특징입니다. [6][7]
서비스 적용 전에 확인할 것
NVIDIA NemotronLabs VoiceChat-11B의 공개 체크포인트는 영어를 대상으로 하며, OpenMDW 1.1 라이선스가 적용됩니다. 실제 서비스에 적용하려면 대상 언어, 도구 호출 품질, 대화 타이밍과 실행 환경을 별도로 검증해야 합니다. [7][26]
4.5 새로운 모델도 같은 질문으로 읽기
이 글에서는 Moshi와 Qwen3-Omni를 서로 다른 구조를 설명하는 기준 사례로 사용했습니다. PersonaPlex와 VoiceChat은 각각 역할·목소리 제어와 도구 호출을 살펴보는 사례입니다. SteerDuplex 연구는 음성 대화 모델이 말투·역할·말하기 속도에 관한 지시를 따르게 하는 문제를 다룹니다. 이들을 하나의 발전 계보나 성능 순위로 묶기보다는, 각 모델이 어떤 문제를 다루는지 비교하는 편이 좋겠습니다. [5][7][13]
모델을 내려받을 수 있는지와 개발하려는 서비스에 쓸 수 있는지는 별개의 문제입니다. 학습된 모델 파일인 체크포인트와 추론 코드, 추가 학습 코드가 공개됐는지, 어떤 언어를 지원하는지 각각 확인해야 합니다. 이용 조건과 실제 서비스 환경에서의 품질 검증도 남아 있습니다.
새 모델을 볼 때는 공개 시점뿐 아니라 음성을 표현하는 방식, 응답 시점을 결정하는 구성요소, 도구 호출을 생성하는 경로를 함께 살펴보면 좋겠습니다.
저는 모델이 도구를 선택하는 일과 서비스가 그 요청을 실행해도 되는지 확인하는 일을 구분하려 합니다. S2S 모델이 함수와 인자를 만들 수 있어도, 그것만으로 해당 사용자의 캘린더를 변경할 권한이 생기지는 않습니다. 다음 장에서는 모델이 만든 요청을 서비스 백엔드가 검증하고 실행하는 구조를 살펴보겠습니다.
5. 모델 밖에는 어떤 구성요소가 필요할까?
5.1 “회의 잡아줘”에는 대화 밖의 일이 들어 있다
앞의 날씨 예시는 예보를 조회하는 읽기 작업입니다. 반면 회의 일정을 만들면 연결된 캘린더의 데이터가 바뀌고 참석자에게 초대가 발송될 수 있습니다. 그래서 두 작업은 필요한 권한도, 사용자 확인 절차도 다릅니다.
이 예제는 서버와 연결되는 음성 앱을 가정합니다. 사용자 기기의 클라이언트는 마이크 입력, 음성 재생, 확인 화면을 맡습니다. 서비스 백엔드는 모델 호출을 조정하고, 연결 계정과 작업 상태를 관리하며, 외부 API를 호출합니다. S2S 모델은 음성 요청을 해석하고 응답을 생성합니다. 도구 호출을 지원하는 모델이라면 함수 이름과 인자도 출력할 수 있습니다. 모델 실행과 작업 처리 기능은 역할에 따라 구분하되, 처음부터 각각을 독립된 서버로 나눌 필요는 없습니다.
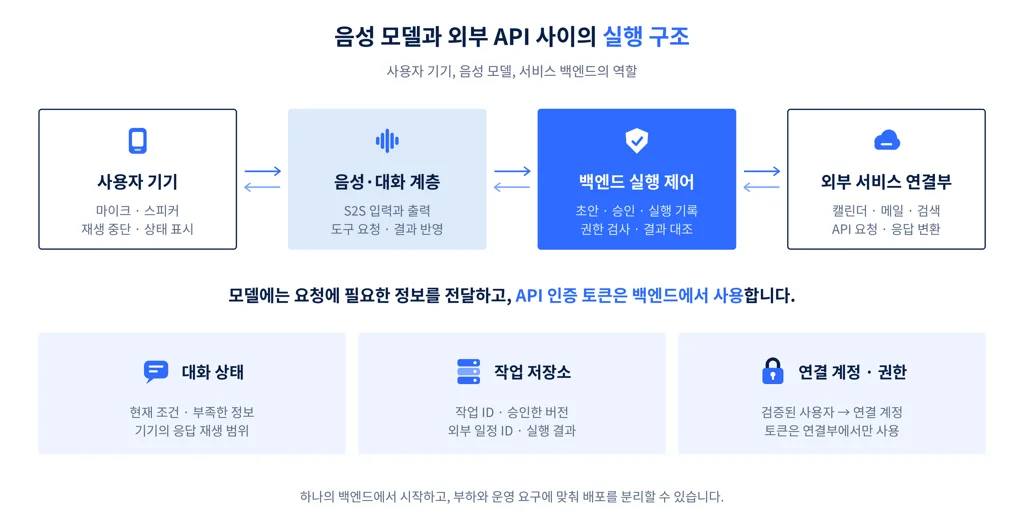
클라이언트에서 받은 음성은 모델의 입력으로 전달됩니다. 모델이 도구 호출을 출력하면 백엔드의 실행 코드가 도구 이름과 인자, 접근 권한을 검사한 뒤 외부 API에 요청합니다. 실행 결과는 작업 기록에 남기고 모델에도 전달합니다. 모델은 그 결과를 바탕으로 다음 응답을 만들고, 클라이언트는 응답 음성을 재생합니다.
백엔드에는 대화 내용과 외부 작업의 상태를 구분해 기록하겠습니다. 대화에는 “세 시가 좋아요”라는 말이 남지만, 실행하려면 날짜, 시간대, 참석자, 사용자가 확인한 요청 내용, 외부 일정 ID가 필요합니다. 이 값을 명시적인 작업 데이터로 보관하면 모델이 이전 발화를 매번 다시 해석하는 데만 의존하지 않아도 됩니다. 두 기록을 반드시 서로 다른 데이터베이스에 저장해야 한다는 뜻은 아닙니다.
5.2 누가 어떤 도구를 고를까?
한 가지 방식은 S2S 모델이 직접 함수 이름과 인자를 생성하는 것입니다. VoiceChat API는 완성된 호출을 연결된 API 클라이언트에 전달하고, 결과를 같은 call_id로 돌려받습니다. 여기서 API 클라이언트는 모델 서버와 통신하는 프로그램을 뜻하며, 휴대전화 앱일 필요는 없습니다. 이 예제에서는 서비스 백엔드가 그 역할을 맡아 외부 API를 호출합니다. 모델이 호출을 생성하는 것과 함수를 실행하는 것은 다른 단계입니다. [10]
다른 방식은 음성 대화를 처리하는 모델과 도구를 선택하는 텍스트 LLM을 나누는 것입니다. 프런트엔드–백엔드 구조를 제안한 연구는 음성 프런트엔드가 위임 신호와 사용자 전사를 전달하면 텍스트 백엔드가 도구를 사용하도록 구성합니다. 여기서 프런트엔드와 백엔드는 음성 처리 모델과 텍스트 처리 모델의 역할 이름이며, 웹 화면과 애플리케이션 서버를 뜻하는 것은 아닙니다. [11]
두 구조 모두 실제 외부 API 실행은 서비스 코드가 맡습니다. 여기서 직접 호출과 위임의 차이는 어느 모델이 도구와 인자를 고르는지입니다. 직접 호출 구조에서는 음성 모델이 올바른 도구와 인자를 출력하는지 확인합니다. 위임 구조에서는 음성 모델과 텍스트 모델 사이에 요청 조건과 대화 맥락이 빠짐없이 전달되는지도 봐야 합니다. 한편 서비스가 제공하는 업무가 정해져 있다면, 도구 선택과 실행 순서를 별도 LLM이 아니라 고정된 워크플로로 구현할 수도 있습니다.
사용자 전사는 어디에 도움이 될까?
사용자 음성, 전사, 도구 인자를 대조하면 이름을 잘못 받아 적었는지, 연락처 선택 과정에서 다른 사람을 골랐는지 확인하는 데 도움이 됩니다. 다만 전사도 틀릴 수 있고, 보조 전사의 내용이 모델 내부의 해석과 항상 같지는 않습니다. 전사만으로 오류 원인을 확정하지는 않습니다. 사용자 전사를 다룬 다른 연구는 응답 텍스트를 만드는 출력 헤드와 나란히 ASR 헤드를 추가해 사용자 발화를 텍스트로 생성합니다. 앞의 VoiceChat에서 소개한 RNN-T 보조 분기와는 다른 구성입니다. [6][12]
5.3 서비스 로그인과 캘린더 접근 권한을 구분한다
서비스에 로그인했다고 Google Calendar를 사용할 권한까지 생기지는 않습니다. 사용자가 Google 계정 접근을 허용하는 절차가 별도로 필요합니다. Google의 웹 서버용 OAuth 흐름은 허용받은 범위에서 API를 호출할 액세스 토큰을 얻는 방법을 제공합니다. 사용자가 앱을 쓰지 않을 때도 접근해야 한다면 별도의 오프라인 접근 설정과 토큰 갱신도 고려해야 합니다. Calendar API는 조회와 일정 편집 등 권한 범위를 구분합니다. 해당 권한 범위를 허용받았더라도, 연결된 계정이 대상 캘린더에 접근할 수 있는지는 별도로 확인해야 합니다. [14][15][17]
이 예제의 백엔드는 검증된 로그인 세션에서 서비스 사용자를 식별하고, 그 사용자에게 연결된 Google 계정과 허용된 캘린더를 조회합니다. 외부 API 호출에 필요한 인증 토큰은 백엔드의 보호된 저장소에서 가져오도록 설계합니다. 모델이 출력한 user_id나 계정 이름은 본인 인증의 증거로 사용하지 않습니다. 인증 토큰도 모델 입력이나 일반 로그에 넣지 않겠습니다.
캘린더 읽기 권한만 있는 사용자에게는 일정 생성 도구를 노출하지 않을 수 있습니다. 그래도 백엔드는 실행할 때 권한을 다시 검사해야 합니다. 모델에게 도구가 보인다는 사실과 현재 그 도구로 특정 캘린더를 변경할 수 있다는 사실은 다릅니다. 사용자가 이번 초대 내용을 확인했는지는 API 접근 권한과 별도로 6.2절에서 다룹니다.
6. 캘린더 하나를 연결해보면 보이는 것들
6.1 사람과 시간부터 확정한다
다시 요청으로 돌아가봅시다.
“내일 오후에 태하 씨랑 30분 회의 잡아줘. 시작하기 10분 전에 알려주고.”
연락처 조회 결과에 태하 씨가 두 명 있다면 구분할 질문이 필요합니다. 이름만 보고 이메일 주소를 만들어서는 안 됩니다. ‘내일’은 요청을 받은 시점과 사용자 시간대를 기준으로 날짜를 정하고, ‘오후’에 해당하는 범위가 불명확하면 다시 묻습니다. 실제 실행 전에는 상대 날짜 표현을 구체적인 날짜와 시각으로 바꿔 확인하는 편이 좋겠습니다.
조회할 캘린더와 시간 범위가 정해지면 빈 시간을 찾습니다. Google Calendar의 freeBusy.query는 각 캘린더의 바쁜 시간 구간을 반환합니다. [16] 후보 시간은 확인하려는 캘린더들의 바쁜 구간을 합친 뒤, 요청한 시간 범위에서 그 구간을 제외해 찾을 수 있습니다. 다만 일부 캘린더에서 오류가 반환되면 모든 참석자의 일정을 확인한 것이 아닙니다. 조회 실패를 빈 시간으로 처리하지 않고, 어느 캘린더까지 확인했는지 구분해야 합니다.
바쁜 구간이 없다고 해서 일정이 없다는 뜻은 아닙니다. Google Calendar에는 일정이 있어도 ‘바쁨’으로 표시하지 않는 경우가 있습니다. [19] 상대 캘린더를 확인하지 못했다면 “연결하신 캘린더에서 오후 세 시부터 30분은 비어 있는 시간으로 나와요. 태하 씨 일정은 확인하지 못했는데, 이 시간으로 초대할까요?”처럼 조회한 범위를 밝혀 안내할 수 있습니다.
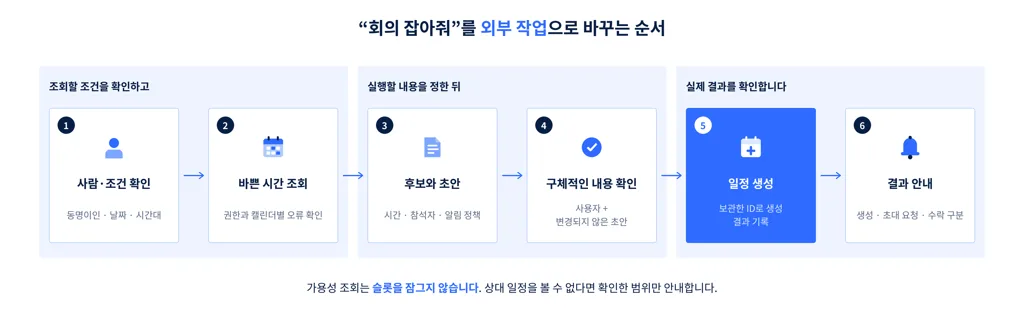
6.2 실행 전 확인은 구체적인 요청에 묶는다
예제 서비스에서는 다른 참석자를 초대하기 전에 내용을 확인합니다. 후보 날짜가 10월 8일로 정해졌다면, 상대 날짜 표현 대신 날짜와 시간대를 짚어 말할 수 있습니다.
“개발팀 태하 씨와 10월 8일 오후 세 시부터 세 시 반까지 회의를 잡을까요? 한국 시간 기준이에요. 초대를 보내고, Google Calendar에 시작 10분 전 알림도 설정할게요.”
저는 빠른 응답과 성급한 실행을 구분하려 합니다. 같은 내용을 계속 확인하면 번거롭지만, 초대 대상이나 시간을 잘못 정한 채 실행해서도 안 됩니다. 이 예제에서는 반복적인 조회에는 확인을 줄이고, 초대를 보내기 전에는 참석자와 시간을 확인합니다. 구체적인 절차는 사용자가 미리 맡긴 범위와 작업의 영향에 맞춰 정할 수 있습니다.
이 절에서 승인은 OAuth 접근 동의가 아니라, ‘이 내용으로 초대를 보내도 된다’는 사용자의 확인을 뜻합니다. 백엔드에는 확인한 사용자, 대상 캘린더, 시간, 참석자와 요청 내용의 버전을 함께 기록합니다. 실행 전에 시간이나 참석자가 바뀌면 새 초안만 만들어서는 안 됩니다. 기존 작업을 실행할 수 없는 상태로 바꾸고, 새 작업을 승인 대기 상태로 둔 뒤 다시 확인받습니다. 이미 전송한 작업은 이 방식으로 교체하지 않고 결과부터 확인합니다. 모델이 approved=true를 출력하는 것만으로 실행을 허용해서는 안 됩니다.
음성의 “네”도 어느 질문에 대한 답인지 연결해야 합니다. 화면이 있다면 일정 요약과 확인 버튼을 제공할 수 있습니다. 음성만 사용한다면 대기 중인 제안을 식별하고, 사용자의 발화가 그 제안에 대한 확인인지 판단하는 처리가 필요합니다. 로그인 여부와 그 “네”가 승인인지는 따로 판단해야 합니다. 승인 상태는 서버가 인증된 사용자의 확인임을 검증한 뒤 기록합니다. 클라이언트가 임의로 보낸 승인 값이나 모델 출력만으로 함수를 호출하면 안 됩니다.
6.3 확정된 내용을 API 요청으로 바꾼다
사용자와 확인한 내용을 일회성 Google Calendar 일정의 생성 요청으로 바꿔보겠습니다. 다음 코드는 핵심 변환 과정만 단순화한 예시입니다. draft는 제목, 시작·종료 시각, 참석자 주소를 담은 객체라고 가정합니다. 서비스에서는 확정 후 값이 바뀌지 않게 관리하고, 시각의 시간대와 순서, 주소 형식을 검증해야 합니다. 참석자 조회와 사용자 의도 확인은 별도 처리입니다. event_id는 백엔드가 작업별로 발급해 보관한 일정 ID입니다.
# draft: 서비스에서 검증하고 확정한 일정 정보
def google_event_body(draft, event_id: str) -> dict:
return {
"id": event_id,
"summary": draft.title,
"start": {"dateTime": draft.start.isoformat()},
"end": {"dateTime": draft.end.isoformat()},
"attendees": [{"email": email} for email in draft.attendees],
"reminders": {
"useDefault": False,
"overrides": [{"method": "popup", "minutes": 10}],
},
}
여기서 reminders는 일정을 생성하는 인증된 사용자의 Google Calendar 알림 설정이며, 참석자 모두에게 동일한 10분 전 알림을 강제하는 값은 아닙니다. AI 앱의 푸시나 음성 안내를 예약하는 코드도 아닙니다. 앱이 직접 사용자에게 알려주는 흐름은 7.5절에서 따로 다룹니다. [20] 일정을 생성하려면 백엔드가 events.insert에 이 본문과 캘린더 ID를 전달해야 합니다. 이때 sendUpdates=all로 참석자에게 일정 알림 전송을 요청할 수 있습니다. 일정 ID는 허용된 문자와 길이를 지켜야 합니다. uuid4().hex로 만든 값은 이 조건을 만족합니다. 이 예제는 그 값을 작업별 event_id로 발급하고, 같은 작업을 다시 전송할 때도 같은 ID를 씁니다. [17][18]
일정 생성이 확인돼도 참석자가 초대를 수락한 것은 아닙니다. 참석자의 응답 상태는 별도 필드로 확인해야 합니다. 또 알림 전송을 요청한 것과 상대가 이메일을 받아 읽은 것은 다른 상태입니다. 사용자에게도 이 차이를 분명히 안내해야 합니다. [18][19]
6.4 시간 초과는 ‘실패’가 아니라 ‘결과를 모름’일 수 있다
일정 생성 요청을 보낸 직후 연결이 끊겼다고 가정해봅시다. 일정이 만들어지기 전에 실패했을 수도 있고, 이미 만들어졌는데 응답만 받지 못했을 수도 있습니다. 후자의 경우 새 ID로 다시 생성하면 중복 일정이 생길 수 있습니다.
Google Calendar는 클라이언트가 일정 ID를 직접 지정할 수 있게 하고, 공식 문서는 이 기능을 통신 실패 뒤 같은 요청을 다시 보낼 때 중복 생성을 막는 용도로 안내합니다. [17] 이 예제는 요청 전에 ID를 기록하고, 결과가 불분명하면 먼저 같은 캘린더의 그 ID를 조회합니다. 동일 ID 오류도 무조건 성공으로 간주하지 않고 기존 일정의 내용을 대조합니다. [21]
따라서 예제에서는 초안과 별도로 실행 작업을 만들고, 상태를 다음처럼 기록합니다.
상태 | 의미 | 백엔드의 다음 처리 |
|---|---|---|
승인 대기 | 실행할 내용을 아직 확인하지 않음 | 사용자 확인을 받거나 초안을 새로 만듦 |
승인 완료 | 변경되지 않은 요청에 대한 확인을 기록함 | 유효기간과 권한을 검사한 뒤 실행 |
실행 중 | 요청을 외부 API에 전송함 | 결과를 기다리고 같은 작업의 중복 실행을 차단 |
완료 | 요청한 내용과 일치하는 생성 결과를 확인함 | 저장한 결과로 응답 |
결과 확인 필요 | 시간 초과나 응답 유실로 결과를 확정하지 못함 | 같은 일정 ID로 조회해 요청 내용과 대조 |
실패 / 실행 전 취소 | 명시적인 실패 응답을 받았거나 전송 전에 취소함 | 이유를 안내하고 이후 처리 여부를 결정 |
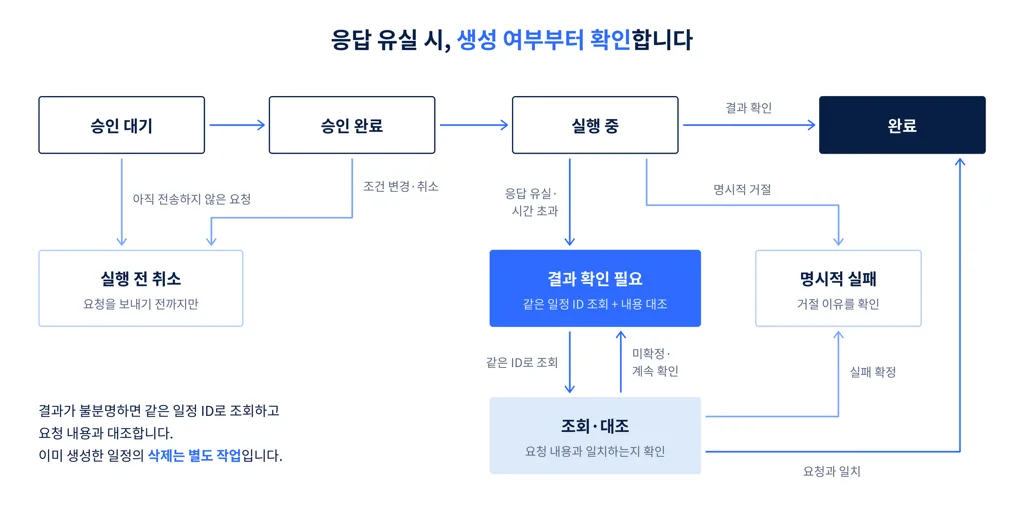
다음 함수는 일정 생성 결과를 작업 상태로 정리합니다. actor는 인증된 사용자와 허용된 캘린더 정보를 담고, approved_job은 서버 측에서 사용자 확인을 검증한 작업입니다. 결과를 확정하지 못하면 완료라고 답하지 않고 확인이 필요하다는 상태를 반환합니다. 이 함수가 실제 재조회 작업을 예약하는 것은 아닙니다.
# service와 WriteOutcomeUnknown은 서비스가 정의하는 실행 인터페이스와 예외
async def finish_meeting(service, actor, approved_job):
try:
event = await service.commit(actor, approved_job.job_id)
except WriteOutcomeUnknown:
return {
"state": "needs_reconcile",
"message": "일정 생성 결과를 확정하지 못해 추가 확인이 필요합니다.",
}
return {
"state": "created",
"event_id": event["id"],
"message": "일정 생성을 확인했습니다. 참석 여부는 상대가 수락해야 확정됩니다.",
}
서비스의 실행 코드는 서버에서 확인한 사용자 권한을 검사하고, 확인한 요청이 바뀌지 않았는지 점검하며, 같은 작업의 중복 호출을 제어해야 합니다. 권한 부족, 확인 유효기간 만료, 제공자의 명시적 거절은 결과 미확정과 구분해 처리합니다. 결과를 대조할 때는 같은 ID의 일정이 있어도 그 일정이 이 작업으로 만든 것인지, 주요 내용이 요청과 일치하는지 확인해야 합니다. 한 번 조회되지 않았다는 이유만으로 새 일정을 만들지는 않습니다. 끝내 결과를 확인하지 못할 때 몇 번 재시도할지, 언제 수동 확인으로 넘길지는 운영 정책으로 정해야 합니다.
이 예제는 실행 제어에 초점을 맞췄습니다. 연락처 검색, 자연어 날짜 해석, 빈 시간 후보 계산, 로그인과 음성 확인 판정은 별도 구현이 필요합니다.
작업 기록과 잠금을 한 프로세스의 메모리 안에만 두면 재시작 시 기록이 사라지고, 여러 서버가 같은 작업을 받는 상황도 막지 못합니다. 운영 환경에서는 원래 사용자 요청 ID와 작업 ID를 데이터베이스에 연결해 보관하고, 같은 작업이 중복 전송되지 않도록 상태 전환과 실행 권한 획득을 원자적으로 처리해야 합니다. 이미 처리한 요청이 다시 들어오면 기존 작업을 찾아야 합니다. 외부 일정 ID만으로 이 전체 과정의 ‘정확히 한 번 실행’이 보장되지는 않습니다. [18]
6.5 빈 시간 조회는 자리를 잡아두는 것이 아니다
사용자 확인을 기다리는 사이에 다른 일정이 생길 수 있습니다. 생성 직전에 다시 조회해도 그 조회와 생성 사이에 변경이 생길 가능성은 남습니다. freeBusy와 events.insert는 각각 조회와 생성을 수행하는 별도 API이기 때문입니다. [16][18] 빈 시간을 조회했다고 그 시간대를 확보한 것은 아닙니다.
개인 일정 관리 서비스라면 충돌을 발견했을 때 다른 시간을 제안하는 정책을 둘 수 있습니다. 회의실이나 좌석처럼 중복 예약을 막아야 하는 자원은 해당 시스템의 예약 규칙도 따라야 합니다. 캘린더의 빈 시간 조회를 자원 예약의 성공으로 취급해서는 안 됩니다.
7. 도구가 많아지고, 작업이 길어지면
7.1 도구가 늘수록 실행 규칙은 나눠야 한다
캘린더 흐름을 이해했다면 다른 서비스도 비슷한 틀에서 살펴볼 수 있습니다. 아래는 확장 가능한 요구사항 예시입니다.
연결 영역 | 사용자 요청 | 추가로 정할 것 |
|---|---|---|
메일·메시지 | “이 내용을 팀에 보내줘.” | 수신자, 초안과 발송, 발송 후 취소 가능성 |
메모·할 일 | “방금 이야기한 걸 할 일로 남겨줘.” | 저장 위치, 중복 항목, 수정 대상 |
사내 문서 검색 | “출장 규정에서 숙박비 기준 찾아줘.” | 사용자별 접근 범위, 출처와 최신성 |
주문·예약 | “배송 상태 알려줘”, “예약 바꿔줘.” | 조회와 변경의 분리, 취소·환불 정책 |
알림·기기 제어 | “회의 전에 알려줘”, “회의실 조명 꺼줘.” | 실행 시점, 대상 기기, 사용자 동의 |
도구 목록에는 조회·변경·외부 발송처럼 작업의 성격을 함께 기록해둘 수 있습니다. 다만 읽기 전용 검색도 민감한 문서를 노출할 수 있습니다. 이 예제의 실행 규칙을 검색으로 확장한다면, 결과를 가져올 때부터 사용자와 조직의 접근 범위를 적용하겠습니다.
검색 문서나 이메일에 “이 내용을 다른 사람에게 보내라”는 문장이 있더라도, 그것만으로 발송을 실행해서는 안 됩니다. 외부 자료의 문장은 데이터로 다루고, 실행 근거는 사용자의 요청과 허용 범위에서 확인해야 합니다. 저는 모델 프롬프트에만 의존하지 않고 백엔드에서도 수신자와 발송 내용을 검사하는 구조를 택하겠습니다.
7.2 필요한 도구만 보여주고, 실행 시에는 다시 검사한다
회의 요청을 처리할 때 배송 조회나 조명 제어의 도구 정의까지 모델에 모두 전달할 필요는 없습니다. 사용자 권한과 현재 업무에 맞춰 후보를 좁히고, 필요한 도구의 입력 규격인 스키마를 불러올 수 있습니다. Anthropic도 도구 검색 기능을 소개하며, 도구 정의를 필요할 때만 불러오는 방식과 그에 따른 추가 지연을 함께 설명합니다. 도구가 적고 자주 함께 쓰인다면 고정 목록이 더 단순할 수 있습니다. [22]
모델이 많은 도구를 얼마나 잘 구분하는지도 확인해야 합니다. VoiceChat 공식 README는 세션당 최대 5개 도구를 권장하고, 여러 도구를 동시에 호출하는 동작도 아직 신뢰하기 어렵다고 안내합니다. 이는 해당 구현의 제약이며 모든 음성 모델의 공통 한도는 아닙니다. [26]
검색으로 찾은 도구도 백엔드의 등록 목록과 대조하고, 호출할 때 인자와 권한을 검사해야 합니다. 독립적인 조회는 병렬로 실행할 수 있지만, 어떤 사람인지 정한 뒤에야 그 사람의 캘린더를 조회할 수 있는 경우처럼 선행 결과가 필요한 작업은 순서를 지켜야 합니다.
첫 버전의 범위를 정한다면 저는 도구 수보다 한 요청을 끝까지 처리할 수 있는지를 먼저 보겠습니다. 캘린더 요청 하나에도 동명이인, 승인 뒤 조건 변경, 생성 후 응답 유실이 있습니다. 기능의 폭은 좁아질 수 있지만, 어떤 실패까지 처리하는지는 확인하기 쉬워집니다. 여러 도구가 있어야 성립하는 업무라면, 그 업무를 완결하는 데 필요한 최소 묶음으로 시작할 수 있습니다.
7.3 MCP는 연결 규격이고, 업무 정책은 서비스가 정한다
MCP(Model Context Protocol)는 AI 애플리케이션이 외부 데이터와 도구를 발견하고 호출하기 위한 공통 규약입니다. 이 글에서는 2026-07-28 정식 사양을 기준으로 도구 이름과 설명, 입력 스키마, 호출 결과를 살펴봅니다. 도구 명세는 사용자가 실행을 통제할 수 있도록 확인 UI를 두라고 권고합니다. Tool Annotation은 실행을 보장하는 값이 아니라 힌트이며, 신뢰할 수 없는 서버의 값을 그대로 믿고 보안 결정을 내려서는 안 됩니다. [23]
서비스 백엔드가 REST API를 직접 호출하든 MCP 서버를 이용하든, 현재 사용자가 그 작업을 허용했는지와 이미 처리한 요청인지 확인하는 절차는 필요합니다. 연결 규격이 이 서비스의 참석자 확인이나 중복 처리 정책까지 정해주는 것은 아닙니다.
7.4 “잠깐, 취소”는 무엇을 취소하는 말일까?
사용자가 “취소”라고 말했을 때는 무엇을 취소하려는지 확인해야 합니다. 지금 재생 중인 설명을 멈추는 것, 아직 보내지 않은 일정 생성 요청을 취소하는 것, 이미 생성된 일정을 삭제하는 것은 서로 다른 작업입니다.
사용자가 날씨를 물을 지역을 바꿨다면, 앞선 조건으로 요청한 결과가 늦게 도착해도 새 응답에 사용하지 않는 정책을 둘 수 있습니다. 반면 일정 생성 요청을 이미 전송했다면 그 결과를 무시해서는 안 됩니다. 서버에 일정이 만들어졌을 수 있기 때문입니다. 먼저 실제 상태를 확인하고, 사용자가 원하는 취소가 일정 삭제라면 별도의 삭제 절차로 이어가야 합니다.
도구 실행 중에도 끼어들 수 있을까?
VoiceChat 공식 README는 도구 실행 중 끼어들기를 지원하지 않는다고 설명합니다. 지원 여부는 모델과 실행 상태별로 확인해야 합니다. [26]
따라서 ‘응답 음성을 중단할 수 있는가’와 ‘도구가 실행되는 동안 새 발화를 처리할 수 있는가’를 나눠 테스트해야 합니다. 백엔드에 작업 상태를 저장하는 것만으로 모델이 지원하지 않는 입력 처리가 가능해지지는 않습니다. 모델이 해당 상태에서 새 말을 받지 못한다면 요청을 다시 확인하는 흐름이나 별도의 취소 UI를 검토해야 합니다.
사용자가 마지막으로 요청한 내용과 외부 시스템에서 실제로 일어난 일을 함께 관리해야 합니다. 응답 ID는 어떤 음성을 중단할지 식별하는 데 쓰고, 작업 ID는 어떤 API 요청의 결과를 확인할지 식별하는 데 씁니다. 요청 내용이 바뀌면 작업 버전도 구분해, 이전 확인이나 결과를 새 요청에 잘못 적용하지 않도록 하겠습니다.
7.5 “10분 전에 알려줘”는 대화가 끝난 뒤에도 남아야 한다
“10분 전에 알려줘”를 처리할 때는 먼저 알림 방식을 정해야 합니다. 앞의 예제는 Google Calendar의 일정 알림을 설정합니다. [20] AI 앱이 푸시나 음성 안내를 직접 제공하려면, 별도의 예약 작업과 전달 수단이 필요합니다. 알림을 예약했다고 사용자의 기기에서 실제로 표시되거나 재생된 것까지 확인된 것은 아닙니다.
서버에서 관리한다면 알림 요청 저장 → 예약 실행기 → 알림 전송 → 결과 기록으로 나눌 수 있습니다. 예약 실행기(스케줄러)는 저장된 알림 시각에 맞춰 작업을 꺼내 실행하는 구성요소입니다. 대화 세션을 유지하는 대신 사용자, 일정 ID, 알림 시각, 채널, 작업 버전을 저장합니다. 회의 시간이나 취소 상태가 바뀌면 알림도 갱신하고, 실행 직전에 저장된 버전이 유효한지 확인합니다. 단말에서 직접 예약할 수도 있지만, 어느 방식이든 알림 권한과 변경·취소 처리는 필요합니다. 앱이 닫힌 상태에서 임의로 음성을 재생할 수 있다고 가정하지는 않습니다.
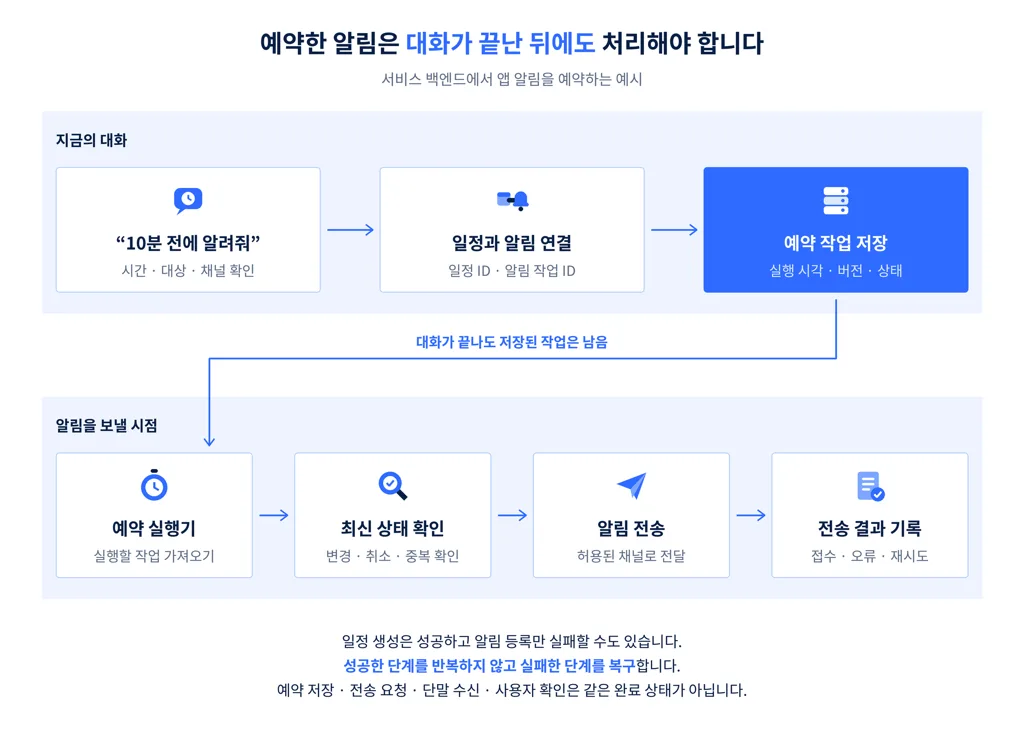
여러 단계가 섞이면 각각의 결과도 남겨야 합니다. 일정은 생성됐지만 앱 알림 등록이 실패했다면, 일정을 다시 만들지 않고 알림 단계만 복구하는 식입니다. 사용자에게도 “일정은 만들었지만 앱 알림은 아직 등록하지 못했어요”처럼 완료한 작업과 남은 작업을 나누어 설명할 수 있습니다.
8. 속도와 정확도는 어디서 확인할까?
8.1 “확인할게요”가 빠른 것과 결과가 빠른 것은 다르다
모델이 바로 “확인해볼게요”라고 답해도 캘린더 조회에는 시간이 더 걸릴 수 있습니다. 서버에서 음성이 만들어졌지만 재생 버퍼에서 기다리는 경우도 있습니다. 속도를 측정할 때는 아래 시점을 나눠보겠습니다.
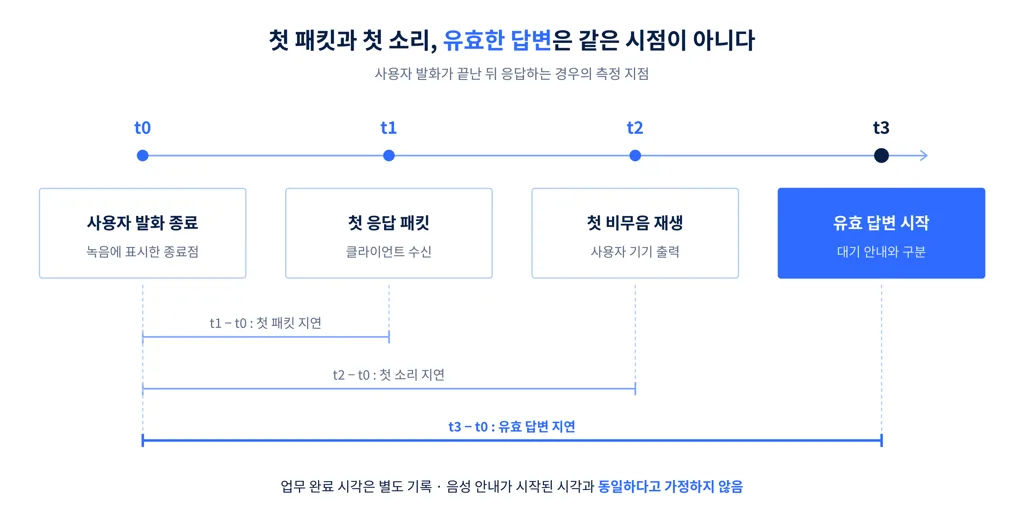
그림의 t0는 평가용 녹음에서 표시한 사용자 발화 종료 시점입니다. 이를 기준으로 첫 응답 오디오 패킷을 받은 t1, 기기에서 응답의 첫 소리를 재생한 t2, 조회 결과처럼 요청에 답하는 내용의 재생이 시작된 t3까지를 나눠 측정합니다. 무음 패킷이 먼저 오는 경우도 있으므로 패킷 수신과 실제 소리의 시작을 같은 지표로 두지 않습니다. 일정 생성 완료 시각은 따로 기록합니다.
실시간 로그의 발화 종료 이벤트는 시스템이 감지한 시점이므로 녹음의 실제 종료점과 구분합니다. 각 지연의 시작·종료 조건과 시계 기준을 정하고, 겹쳐 실행된 처리 시간을 단순 합산하지 않습니다. 사용자 발화가 끝나기 전에 반응한 경우도 별도 유형으로 집계합니다.
8.2 음성 청크와 캐시를 볼 때
청크는 한 번에 모아 처리하거나 보내는 오디오 구간입니다. 16kHz는 1초에 16,000개 샘플을 기록한다는 뜻이고, 모노·PCM16은 한 채널의 샘플을 각각 2바이트로 저장하는 형식입니다. 이 조건에서 20ms 분량은 16,000 × 0.02 × 2 = 640바이트입니다. 아래 코드는 그 크기를 계산합니다.
def pcm_chunk_bytes(sample_rate: int, chunk_ms: int, channels: int = 1) -> int:
values = (sample_rate, chunk_ms, channels)
if any(type(value) is not int or value <= 0 for value in values):
raise ValueError("Use positive integers")
samples, rest = divmod(sample_rate * chunk_ms, 1000)
if rest:
raise ValueError("Whole samples are required")
return samples * channels * 2 # PCM16: 샘플당 2바이트
20ms는 계산 예시이지 공통 권장값이 아닙니다. VoiceChat API는 24kHz·모노·PCM16과 권장 80ms 청크를 안내합니다. 네트워크 청크와 모델 내부 프레임도 다른 단위일 수 있습니다. 먼저 지원 설정을 기준선으로 두고 전송 빈도와 재생 끊김을 함께 보면서 조정하는 편이 좋습니다. [10]
Transformer는 다음 출력을 만들 때 앞선 토큰의 정보도 참조합니다. KV 캐시는 이때 반복해서 필요한 key와 value 벡터를 저장해 재계산을 줄이는 방법입니다. 대화 길이와 동시 세션 수에 따라 캐시 메모리 사용량도 확인해야 합니다. [24] 반면 Qwen3-Omni의 Code2Wav는 인과적 합성곱으로 음성 토큰을 파형으로 바꾸는 단계의 지연을 줄입니다. [3] 같은 저지연 기술이라도 어느 단계의 계산을 줄이는지는 다릅니다.
모델 지원과 런타임 지원
Qwen3-Omni 공식 저장소의
vLLM Serve Usage안내에 나온 서빙 방식은 Thinker만 지원합니다. 텍스트 응답을 받았다고 음성 생성까지 검증한 것은 아닙니다. 사용할 체크포인트와 런타임의 지원 조합을 함께 기록해두는 편이 좋습니다. [4]
8.3 모델을 바꾸기 전에 대기 구간을 찾는다
모델 추론에 시간이 걸리는지, 외부 API 응답을 기다리는지, 재생 버퍼에 음성이 쌓이는지부터 나눠보겠습니다. 다음 항목을 측정하면 우선 개선할 구간을 찾는 데 도움이 됩니다.
구간 | 확인할 것 |
|---|---|
입력·추론 | 음성 누적 시간, 불필요한 변환, 캐시, 대기열 |
도구 선택 | 노출한 도구 수, 검색 시간, 잘못 고른 도구와 인자 |
외부 실행 | API별 지연, 제한시간, 재시도와 결과 확인 시간 |
재생 | 패킷 수신부터 실제 소리까지, 중단 뒤 남은 오디오 |
동시 세션 | 목표 부하에서 중앙값(p50)·95백분위(p95) 지연, 메모리, 끊김과 오류율 |
작업 실행은 오디오 수신 루프와 분리하고, API별 제한시간을 둡니다. 다만 제한시간이 지났다고 외부 쓰기 작업까지 취소됐다고 가정하지 않습니다. 앞의 일정 생성 예제처럼 결과 확인 경로가 필요합니다.
모델의 생성을 멈춰도 이미 전송한 음성이 기기에서 계속 재생될 수 있습니다. 생성 중단, 서버 전송 대기열 정리, 클라이언트 재생 버퍼 비우기를 각각 처리해야 합니다. 다음 대화를 위해서는 생성한 응답 전체와 기기에서 실제로 재생한 구간도 구분하는 편이 좋습니다. 재생이 끝났다는 정보는 사용자가 내용을 들었거나 이해했다는 증거와는 다릅니다.
8.4 좋은 목소리와 정확한 실행은 따로 평가한다
기본 요청이 정상적으로 처리되는지 확인한 뒤에는, 조건 변경과 실패가 섞인 상황도 테스트해야 합니다. 캘린더 예제라면 다음 항목을 함께 확인하겠습니다.
상황 | 확인할 결과 |
|---|---|
동명이인·권한 부족 | 대상을 확인하고, 볼 수 없는 캘린더를 비어 있다고 답하지 않는가? |
승인 후 시간 변경 | 바뀐 일정을 이전 승인만으로 실행하지는 않는가? |
응답 유실·재접속 | 같은 작업이 중복 생성되지 않고 결과를 조회하는가? |
말하는 도중 취소 | 재생 중단과 작업 취소를 구분하는가? 이미 실행된 결과도 추적하는가? |
부분 성공 | 일정 생성과 알림 등록의 성공 여부를 따로 안내하는가? |
모호한 확인 발화 | 맞장구를 참석자 초대 승인으로 잘못 처리하지 않는가? |
실제 음성 서비스를 평가할 때는 한국어 이름·시간 표현, 배경 잡음, 마이크와 스피커, 목표 동시 세션 조건을 포함한 통합 테스트가 필요합니다. 출력 음성이 마이크에 다시 들어가는 상황도 포함합니다. 웹 미디어 캡처 표준은 에코 제거와 잡음 억제를 별도 설정으로 정의하지만, 설정이 있다는 사실만으로 모든 기기에서 같은 효과를 기대할 수는 없습니다. [25]
외부 평가를 볼 때도 무엇을 측정했는지 살펴야 합니다. 텍스트 답변의 정확도, 재생된 음성의 품질, 도구 실행 결과는 서로 다른 대상입니다. 한 항목의 점수를 전체 서비스 품질로 읽기보다, 개발하려는 서비스에서 필요한 항목을 따로 확인하는 편이 낫습니다.
실행 로그에는 요청 ID, 작업 ID, 도구 호출 ID를 연결해 남기고 인증 토큰은 제외하겠습니다. 입력과 결과는 필요한 항목만 남기고, 개인정보는 마스킹하며 보관 기간을 정해야 합니다. 모델·런타임 버전, 시스템 프롬프트 버전, 오디오 형식, 동시 세션 수를 기록하면 실패 조건을 비교하는 데 도움이 됩니다. 실제 음성이나 대화 내용을 검증에 사용하려면 수집·이용 범위와 사내 개인정보 처리 기준을 먼저 확인해야 합니다. 일반 로그에 민감한 원문을 추가하기보다는 필요한 검증 데이터를 별도로 관리하는 편이 좋겠습니다.
9. 마치며
“오늘 우산 챙겨야 할까?”라는 질문에서 시작해 캘린더에 회의를 만드는 과정까지 살펴봤습니다. S2S 모델을 비교할 때는 음성을 어떤 표현으로 다루는지, 언제 반응하는지, 도구 호출을 어떻게 생성하는지 볼 수 있습니다. 서비스를 만들 때는 여기에 사용자의 권한, 이번 요청에 대한 확인, 외부 API의 실제 결과를 연결해야 합니다.
이 글에서 제가 중요하게 본 것은 모델이 요청한 작업과 외부 시스템에서 실제로 처리된 결과를 구분해 확인하는 것입니다. 음성 모델이나 별도의 텍스트 모델은 요청을 해석하고 사용할 도구와 인자를 제안할 수 있습니다. 그 요청을 받은 백엔드는 현재 사용자의 접근 권한과 필요한 확인 절차를 검사한 뒤 API를 호출하고 결과를 기록합니다. 기록한 결과는 다시 모델에 전달해 응답에 반영합니다. 구성요소가 늘어나는 부담은 있지만, 외부 데이터를 바꾸는 서비스에서는 이 구분이 오류를 찾고 복구하는 데 도움이 된다고 봅니다.
사용자 확인도 횟수보다 내용이 중요하다고 생각합니다. 이미 확인한 내용을 반복해서 묻기보다는, 초대 대상이나 시간이 달라졌을 때 다시 확인하는 식입니다. 기능을 추가할 때도 성공 경로뿐 아니라 응답 유실, 조건 변경, 부분 성공을 어떻게 처리할지 함께 검토하는 편이 좋겠습니다.
서비스의 목적에 따라 강조점은 달라집니다. 대화 중심의 캐릭터 서비스라면 목소리와 반응 타이밍이 더 중요할 수 있습니다. 반면 사용자의 계정으로 실제 일을 처리한다면, 대화가 자연스러운지와 요청한 작업이 정확하게 실행됐는지를 함께 평가해야 합니다. 하지 못한 일이 있다면 그 상태까지 사용자에게 분명히 알려주는 것이 이 글에서 제안하는 기준입니다.
참고 자료
논문은 각 항목에 표시한 버전을, MCP는 2026-07-28 정식 사양을 참고했습니다.
[1] Moshi: a speech-text foundation model for real-time dialogue
Défossez et al. · arXiv:2410.00037v2 · 2024
Moshi: a speech-text foundation model for real-time dialogue
[2] Moshi 공식 저장소
Kyutai · Model architecture / Mimi
GitHub - kyutai-labs/moshi: Moshi is a speech-text foundation model and full-duplex spoken dialogue framework. It uses Mimi, a state-of-the-art streaming neural audio codec.
[3] Qwen3-Omni Technical Report
Qwen Team · arXiv:2509.17765v1 · §2.4–2.5
Qwen3-Omni Technical Report
[4] Qwen3-Omni 공식 저장소
Qwen · Model variants / vLLM Serve
GitHub - QwenLM/Qwen3-Omni: Qwen3-omni is a natively end-to-end, omni-modal LLM developed by the Qwen team at Alibaba Cloud, capable of understanding text, audio, images, and video, as well as generating speech in real time.
[5] PersonaPlex: Natural Conversational AI With Any Role and Voice
NVIDIA Research · Architecture · 2026
NVIDIA PersonaPlex: Natural Conversational AI With Any Role and Voice
[6] NemotronLabs VoiceChat: An Open Full-duplex Speech-to-Speech Model with Tool Calling Capabilities
NVIDIA · arXiv:2609.21967 · 2026 · Abstract
NemotronLabs VoiceChat: An Open Full-duplex Speech-to-Speech Model...
[7] NVIDIA-NemotronLabs-VoiceChat-11B 모델 카드
NVIDIA · Architecture / Known Limitations
nvidia/NVIDIA-NemotronLabs-VoiceChat-11B · Hugging Face
[8] DuplexCascade: Full-Duplex Speech-to-Speech Dialogue with VAD-Free Cascaded ASR-LLM-TTS Pipeline and Micro-Turn Optimization
arXiv:2603.09180 · 2026
DuplexCascade: Full-Duplex Speech-to-Speech Dialogue with VAD-Free...
[9] Turns overview
LiveKit · Turn detection / Interruptions
Turns overview | LiveKit Documentation
[10] VoiceChat Realtime API Reference
NVIDIA NeMo · Audio parameters / Function calling
Speech/voicechat_realtime_instructions/api-reference.md at nemotron-labs-voicechat · NVIDIA-NeMo/Speech
[11] A frontend-backend architecture for tool calls in full-duplex speech models
arXiv:2609.19334 · 2026 · Abstract
A frontend-backend architecture for tool calls in full-duplex speech models
[12] Enabling Streaming User Transcription in Full-Duplex Speech-to-Speech Models
arXiv:2609.15759 · 2026 · Abstract
Enabling Streaming User Transcription in Full-Duplex...
[13] SteerDuplex: Steerable Duplex Speech Dialogue Models
arXiv:2609.12623 · 2026
SteerDuplex: Steerable Duplex Speech Dialogue Models
[14] Choose Google Calendar API scopes
Google · 읽기·편집 권한 범위
Choose Google Calendar API scopes | Google for Developers
[15] Using OAuth 2.0 for Web Server Applications
Google · authorization / token refresh
Using OAuth 2.0 for Web Server Applications | Authorization | Google for Developers
[16] Freebusy: query
Google Calendar API v3 · calendars.errors / busy
Freebusy: query | Google Calendar | Google for Developers
[17] Create events
Google Calendar · event ID / attendees
Create events | Google Calendar | Google for Developers
[18] Events: insert
Google Calendar API v3 · id / sendUpdates / reminders
Events: insert | Google Calendar | Google for Developers
[19] Events resource
Google Calendar API v3 · attendees.responseStatus / start / end
Events | Google Calendar | Google for Developers
[20] Reminders and notifications
Google Calendar · 사용자별 알림과 초대 알림
Reminders and notifications | Google Calendar | Google for Developers
[21] Handle API errors
Google Calendar · 409 / 403 / 429 / retry
Handle API errors | Google Calendar | Google for Developers
[22] Introducing advanced tool use on the Claude Developer Platform
Anthropic · Tool Search / trade-offs
Introducing advanced tool use on the Claude Developer Platform
[23] Tools
Model Context Protocol · 2026-07-28 정식 사양 · 사용자 통제 / 스키마 / 보안
Tools - Model Context Protocol
[24] How caching works
Hugging Face Transformers · KV cache
How caching works · Hugging Face
[25] Media Capture and Streams
W3C · echoCancellation / noiseSuppression
Media Capture and Streams
[26] NemotronLabs VoiceChat 공식 README
NVIDIA NeMo Speech · Known Limitations / 모델·추론 안내
Speech/README.md at nemotron-labs-voicechat · NVIDIA-NeMo/Speech
[27] Creative Commons Attribution 4.0 International — License
Creative Commons · Attribution 4.0 International
Deed - Attribution 4.0 International - Creative Commons
[28] Google Developers Site Policies
Google for Developers · Site Policies
Site Policies | Google for Developers
출처 및 이용 표기
Google Developers 관련 설명[14]–[21]은 Google의 문서[28]를 CC BY 4.0[27]에 따라 한국어로 요약·재서술했습니다.
Qwen3-Omni의 구조 설명과 도식은 Jin Xu 외, Qwen3-Omni Technical Report[3]를 CC BY 4.0[27]에 따라 한국어로 요약·재구성했습니다.